为什么做这个项目?
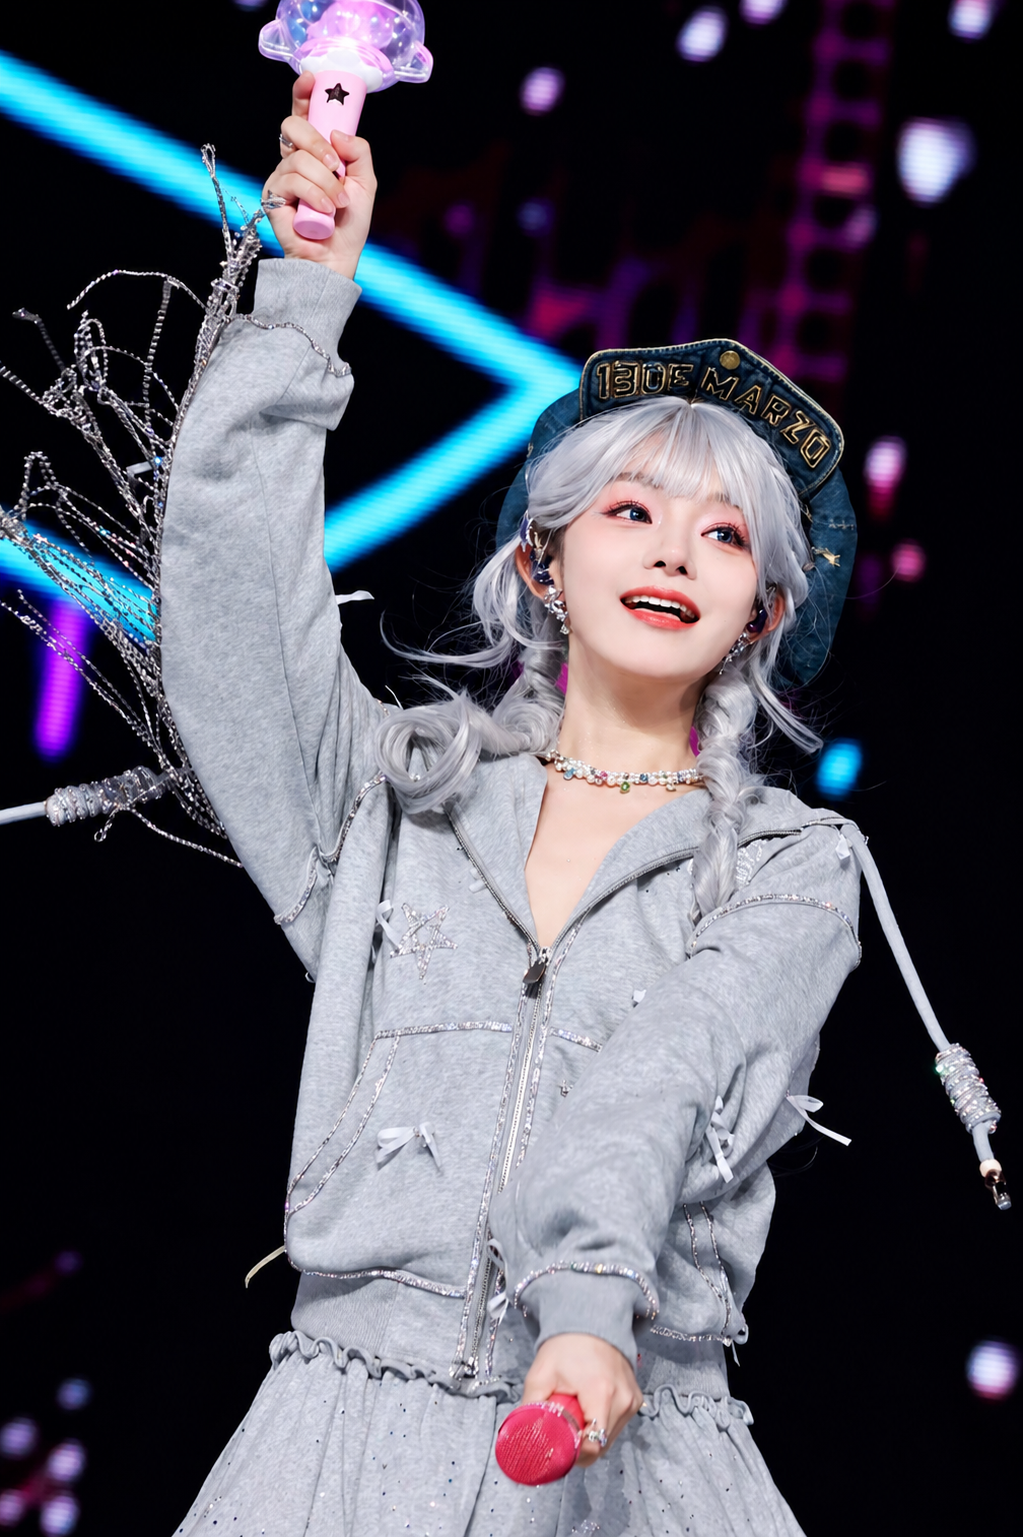
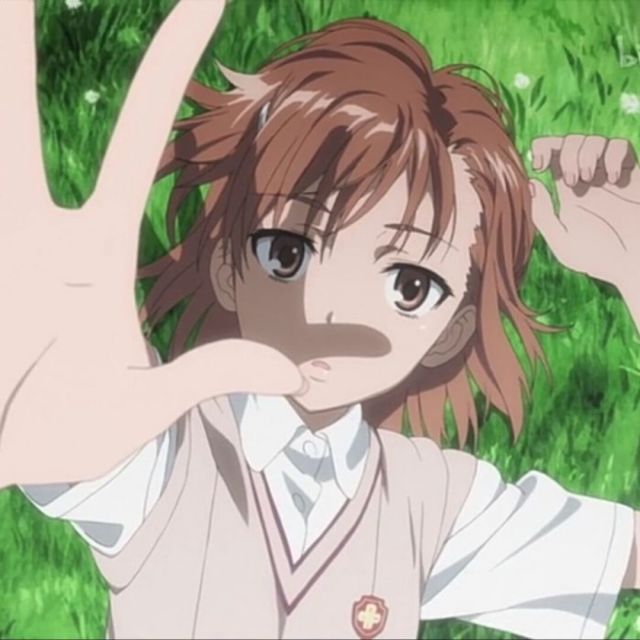
我一直很好奇:能不能把一张普通的照片,直接变成宫崎骏风格的动漫画面?
带着这个问题,我开发了 玫瑰星云绘(Rose Nebula Painter)——一个基于 GAN 的照片动漫化 Web 应用。
“那是我,我的玫瑰星云,献给这个世界。“
效果预览
用户上传一张照片,选择喜欢的动漫风格,调整强度和后期参数,就能得到一张动漫化的图片。
支持的风格包括:
| 类别 | 风格 |
|---|---|
| 风景动漫 | 宫崎骏/吉卜力、新海诚/你的名字、可爱风 |
| 人像风格 | 日系人脸、素描风、人脸彩绘 |
| 艺术风格 | 迪士尼、双城之战、漫画、K-pop、像素风… |
总共 17+ 种画风,而且可以通过添加 ONNX 模型文件无限扩展。
技术架构
整体架构
用户浏览器 → React 前端 → Flask API → GAN 模型推理 → 后期处理 → 返回结果双引擎设计
项目同时支持两套 GAN 推理引擎:
PyTorch 引擎(AnimeGANv2)
- 3 个 portrait 模型
- 基于 MobileNet 的轻量级生成器
- 自动选择 CUDA/CPU
ONNX 引擎(AnimeGANv3)
- 6 个内置模型 + 无限扩展
- 自动选择 CUDA > DirectML > CPU
- 支持 AMD 显卡(DirectML)
为什么用两套引擎?因为 AnimeGANv2 的 PyTorch 模型在人像上效果更好,而 AnimeGANv3 的 ONNX 模型覆盖了更多画风。两者互补。
模型自动发现
ONNX 引擎有一个很酷的特性:模型自动发现。
系统启动时会扫描 deploy/ 目录下的所有 .onnx 文件,通过文件名关键词匹配自动注册到对应的风格。比如文件名包含 Hayao 就自动映射到「宫崎骏」风格。
这意味着用户只需要把新的 .onnx 文件丢进目录,重启服务,新风格就自动出现了——不需要改任何代码。
生成器网络结构
AnimeGANv2 的生成器基于 MobileNet 的思想:
输入图像 ↓编码器(卷积下采样) ↓4 个 InvertedResBlock(倒残差块) ↓解码器(双线性插值上采样) ↓Tanh 激活 → 输出图像InvertedResBlock 使用深度可分离卷积,参数量很小但效果很好。整个模型只有几 MB,推理速度很快。
7 级后期增强流水线
GAN 输出的结果通常需要微调。我设计了一个 7 级后期处理流水线,每个参数都可以独立调节(0.0 ~ 1.0):
# 流水线处理顺序1. 平滑(高斯模糊去噪)2. 边缘(自适应阈值边缘检测,叠加动漫线条)3. 饱和度(让颜色更鲜艳)4. 对比度(增强明暗对比)5. 锐化(让线条更清晰)6. 细节(从原图提取高频纹理回填)7. 暗角(径向暗化,聚焦中心)其中最有意思的是第 6 步:细节回填。
GAN 在风格化过程中会丢失一些细节(比如皮肤纹理、衣服褶皱)。细节回填的原理是:
高频细节 = 原图 - 高斯模糊(原图)输出 = GAN结果 + α × 高频细节这样既保留了动漫风格,又不会丢失太多真实感。
风格强度控制
风格强度滑块的实现非常简洁:
result = Image.blend(original, styled, intensity)一行代码,通过 alpha 混合在原图和风格化结果之间插值。intensity=0 就是原图,intensity=1 就是完全风格化。简单但有效。
前端设计
前端用 React 18 构建,没有用任何 CSS 框架,所有样式手写。
玫瑰星云动画
首页 header 有一个很炫的动画:星星从随机位置汇聚,最终形成一朵玫瑰星云的形状。
实现方式是用极坐标方程生成玫瑰曲线上的点:
// 玫瑰曲线:r = sin(t) * sqrt(|cos(t)|) / (sin(t) + 1.4)const r = Math.sin(t) * Math.sqrt(Math.abs(Math.cos(t))) / (Math.sin(t) + 1.4);const x = r * Math.cos(t);const y = r * Math.sin(t);然后用 CSS 自定义属性 + @keyframes 让星星从随机起始点飞向目标点。
性能优化
- 图片最大尺寸限制 1024px
- ONNX 模型启动时预热(dummy input)
- JPEG 编码质量 85,减小传输体积
- 输入尺寸对齐到 8 的倍数(ONNX 模型要求)
优雅降级
项目有一个 fallback 机制:如果既没有 PyTorch 也没有 ONNX 模型,系统会用纯 PIL 实现一个简易卡通效果:
# Demo 模式:边缘检测 + 色调分离 + 色彩增强edges = image.filter(FIND_EDGES)poster = image.quantize(colors=16).convert('RGB')result = Image.blend(poster, edges, 0.3)这样即使没有任何模型权重,项目也能正常运行和演示。
技术栈总结
| 层级 | 技术 |
|---|---|
| 前端 | React 18 + Vite 5 |
| 后端 | Flask + flask-cors |
| AI 推理 | PyTorch (AnimeGANv2) + ONNX Runtime (AnimeGANv3) |
| 图像处理 | Pillow + NumPy |
| 模型架构 | MobileNet-like 生成器 + 深度可分离卷积 |
遇到的坑
-
ONNX 输入尺寸对齐:AnimeGANv3 要求输入尺寸是 8 的倍数,“tiny” 模型要求 16 的倍数。不对齐会直接报错。
-
DirectML 兼容性:在 AMD 显卡上,ONNX Runtime 的 DirectML provider 有时会比 CPU 还慢。需要测试选择最优 provider。
-
大图片内存爆炸:4K 图片直接送进 GAN 会 OOM。解决方案是限制最大 1024px,推理完再缩放回去。
-
风格强度的直觉:用户不理解 0.0~1.0 的含义。后来加了预设(轻度/中度/重度)才好一些。
写在最后
这个项目让我学到了很多:从 GAN 的原理到模型部署,从 Flask API 设计到 React 前端动画。
最让我满意的是「模型自动发现」功能——丢一个文件进去就能用,这种体验很爽。
项目技术栈:Python · PyTorch · ONNX · Flask · React · Vite
如果你也对 AI 图像风格化感兴趣,推荐从 AnimeGANv2 开始,它的论文和代码都很好理解。模型很轻(几 MB),一张普通游戏本就能跑出不错的效果——这是少数几个个人开发者也能完整走通「训练 → 部署 → 上线」全流程的 AI 方向。